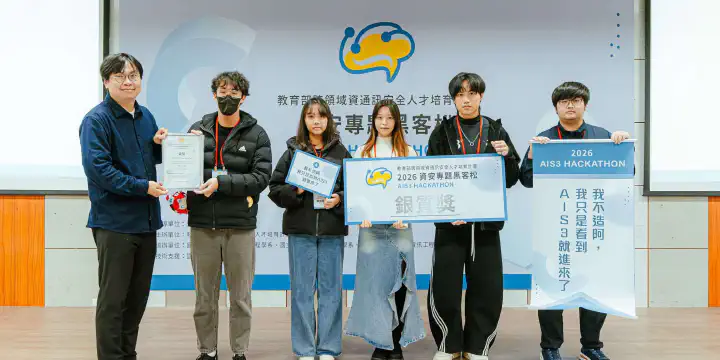
2026 AIS3 HACKATHON|資安專題黑客松銀質獎
When the imposter is SUSඞ …
以 Chrome Extension 結合靜態資訊比對與圖像識別,在 Facebook 廣告上直接呈現詐騙風險。
- Year
- 2026
- Role
- 隊長/資訊比對/模組整合/擴充功能
- Team
- 5 人團隊
- Share
- 70%
專案總覽
專題以競賽提供的詐騙廣告識別資料集為基礎,鎖定 Facebook 廣告情境,開發能直接在瀏覽頁面上標示風險的 Chrome Extension,獲得銀質獎。
問題與動機
詐騙廣告同時混合粉專資訊、外部連結、文案與圖片;只檢查單一訊號容易誤判,而完整分析又可能造成等待與操作負擔。
粉專、網址、文字與影像需要以不同方法檢查後再合併。
分析必須融入社群瀏覽流程,避免成為使用者的新負擔。
方法與核心內容
系統先以靜態資訊快速判讀,針對可疑內容再結合圖像識別與本地 LLM 深度分析,最後依各模組的可調整權重計算綜合分數,並直接在廣告旁顯示判斷。
比對粉專、連結與文本資訊,先篩出高風險廣告。
對可疑項目執行視覺及語意分析,再整合成最終分數。
技術脈絡
瀏覽器擴充功能負責擷取與呈現,後端服務負責資料查詢、圖像與語意模型分析。
四模組風險評分
初始版本將廣告拆成文字、網域、粉專與影像四個模組,預設各占 25% 權重。這組比例是原型的初始設定,不是固定不變的規則;後續可依資料驗證結果、模組準確度或實際使用情境個別調整。如此能避免系統只因單一關鍵字或圖片直接判定詐騙,也能保留每個風險訊號的來源。
輸入訊號
- 文字:簡繁用語、投資/博弈/冒名/購物類型、保證獲利與零風險等高風險詞彙。
- 網域:Facebook 轉址後的最終網址、網域年齡、同 IP 網域、重新導向與頁面內容。
- 粉專:登入後取得粉專與歷史廣告資訊,補足單篇廣告以外的脈絡。
- 影像:將廣告內容轉成 224×224 輸入,交由 ViT 二元分類器判斷。
ViT 圖像分類管線
圖像模組以 Vision Transformer 搭配 transfer learning 與 PyTorch 建立二元分類器。非詐騙樣本由 Meta Ad Library 蒐集;由於直接截圖會要求使用者停留在廣告畫面,系統改將擷取到的貼文內容重新生成分析用圖像,再完成縮放與壓縮。
處理步驟
- 擷取貼文中的文字與媒體內容,生成一致格式的分析圖片。
- 將圖片 resize/compress 為 224×224,符合模型輸入。
- 輸出詐騙與非詐騙的分類結果,再與其他模組合併。
網域情資與重新導向分析
先解析 Facebook 包裝的跳轉連結並清理網域,再查詢 WHOIS、HackerTarget、SpiderFoot 與 reverse IP 等資料。新註冊 90 天內的網域、可疑重新導向、同 IP 上的鄰近網域與頁面內容都會成為評分訊號。
本地多模態 LLM 深度判讀
快速初判後仍可疑的廣告,才送入本地 llama3.2-vision。模型同時接收前階段分析摘要與廣告圖像,產生第二層判斷;本地部署可減少把使用者瀏覽內容送往外部服務的隱私風險。
執行流程
採分層分析避免所有廣告都進入高成本模型,同時保留可疑內容的深入判讀。
01 — 擷取廣告訊號
由 Extension 收集粉專、連結、文案與圖片等資訊。
02 — 計算各模組權重
分別取得靜態比對與圖像識別結果,必要時送入本地 LLM;各模組權重可依驗證結果調整,不限定永久維持平均分配。
03 — 就地呈現判斷
將平均權重與分析資訊直接顯示在原廣告介面。
快取與可疑廣告資料庫
完成深度分析後,只保存仍被判定可疑的項目,包括粉專、廣告 ID、相關廣告 ID 與目標連結。下次遇到相同或關聯廣告時可重用結果,避免重複執行昂貴的模型分析。
分層判斷的設計取捨
Extension 先提供快速回饋,再由後端補充較慢的情資與模型結果。這種設計犧牲部分即時完整性,換取可接受的瀏覽體驗、較低運算成本,以及每個分數來源的可追溯性。
我的貢獻
貢獻比例 70%,負責團隊規劃、靜態資訊比對、模組整合與擴充功能完善。
- 01隊長與執行規劃定義解法、分工並控制黑客松開發節奏。
- 02靜態資訊比對開發粉專、連結與文字訊號的快速判斷。
- 03模組整合整合資訊比對、圖像識別與加權結果。
- 04Chrome Extension完成廣告擷取、結果呈現與互動流程。
成果與反思
專題完成可操作的瀏覽器擴充功能與多模態分析流程,並在 2026 AIS3 HACKATHON 獲得銀質獎。